做量化研究时,很多初学者最常犯的错误,就是刚写出一个因子公式,就直接扔进回测框架跑组合净值。
看到净值曲线右上角仰角漂亮,就认定这是一个“高收益 Alpha”;看到净值回撤或者跑输大盘,就顺手给公式加两个过滤参数,直到净值好看为止。
这种跳过信号统计检验直接看回测净值的做法,本质上是用多层交易规则的偶然巧合,掩盖了因子本身的预测缺陷。一个策略的回测净值,混杂了标的池过滤、头寸加权方式、止损止盈点位、甚至特定调仓日的大盘运势。
要客观评价一个量化因子是否具备真正的截面预测力,必须将信号层与组合执行层彻底剥离。在投研流水线中,一个合格的单因子必须依次通过四道硬核检验关卡:
- 截面预测力:Rank-IC 均值、信息比率(IC_IR)与统计显著性;
- 多空区分度:五分层(Quantile Analysis)收益的单调性与尾部特征;
- 信号生命周期:时序滞后衰减与因子半衰期(Half-life);
- 现实物理约束:换手率测算与交易摩擦(佣金、冲击)对纸面 Alpha 的侵蚀程度。
这篇基于本地 140 只核心流动性标的从 2021 年初至 2026 年底共 1033 个交易日的真实日 K 数据,以经典的 5 日短期反转因子为例,系统拆解这四大检验标准。
关卡一:Pearson IC vs Rank-IC 与极端值稳健性
信息系数(Information Coefficient, IC)是衡量因子值与未来预期收益率相关程度的核心指标。
在实际应用中,存在两种计算口径:
- Pearson IC:因子原始值与未来一期收益率的线性相关系数;
- Spearman Rank-IC:因子截面百分位排名与未来一期收益率百分位排名的秩相关系数。
在多因子选股体系中,严禁以 Pearson IC 作为核心验收准绳,必须统一使用 Rank-IC。
为什么必须用 Rank-IC?
核心原因有两个物理与统计事实:
- 极端离群值绑架:股票市场截面收益率并非标准正态分布,而是具有明显的厚尾特征。如果某只股票因突发重组、拆股未复权跳空或极端行情暴涨 50%,在计算 Pearson 协方差时,这个孤立极值会瞬间主导分子求和项,导致当天的 Pearson IC 被单只股票强行拉高或拉低。而 Rank-IC 将原始数值转化为 区间内的均匀百分位排名,天然免疫离群值的扰动。
- 非线性单调需求:构建多头股票组合时,核心需求是“因子得分前 10% 的标的,未来收益率也排在前 10%”,并不要求因子数值与未来收益率之间满足严格的等比例线性函数。Rank-IC 度量的正是这种非线性的单调排序能力。
工业级评价标杆
在日频截面因子检验中,常用的统计验收标尺如下:
- Rank-IC 均值: 视为初步有效; 属于强有效因子。
- 信息比率(IC_IR):年化信息比率 。它衡量的是预测能力的时序稳定性。 属于可用基线; 具备优异的夏普支撑; 属于极其稳健的底层核心驱动因子。
- IC 胜率:截面 的交易日占比。合格线通常在 以上, 以上表明信号在不同市场风格中具备高度抗波动韧性。
- t 统计量:。绝对值必须 (对应显著性水平 ),确保预测力无法用纯随机游走解释。
在实测的 1033 个交易日中,经过除权跳空清洗后的 5 日反转因子呈现出标准的 Alpha 特征:
- Rank-IC 均值:
+0.0298 - IC 标准差:
0.2288 - 年化 IC_IR:
2.06 - IC 胜率:
55.6% - t 统计量:
4.22(统计显著性 )
关卡二:分层回测(Quantile Analysis)与尾部驱动特征
Rank-IC 确认了整体截面的相关性,但无法回答资金在具体分组上的收益分布。这就是分层检验(Quantile Analysis)必须接棒的原因。
分层测试的标准操作流程:
- 在每个调仓日收盘后,按因子得分对全截面有效股票进行升序排序;
- 将股票池均匀划分为 个组(通常为 5 组或 10 组)。Group 1 代表因子得分最低的股票集合,Group 5 代表因子得分最高的股票集合;
- 每组内部采用等权加权,持有至下一期,计算各组在样本期内的累计复利净值。
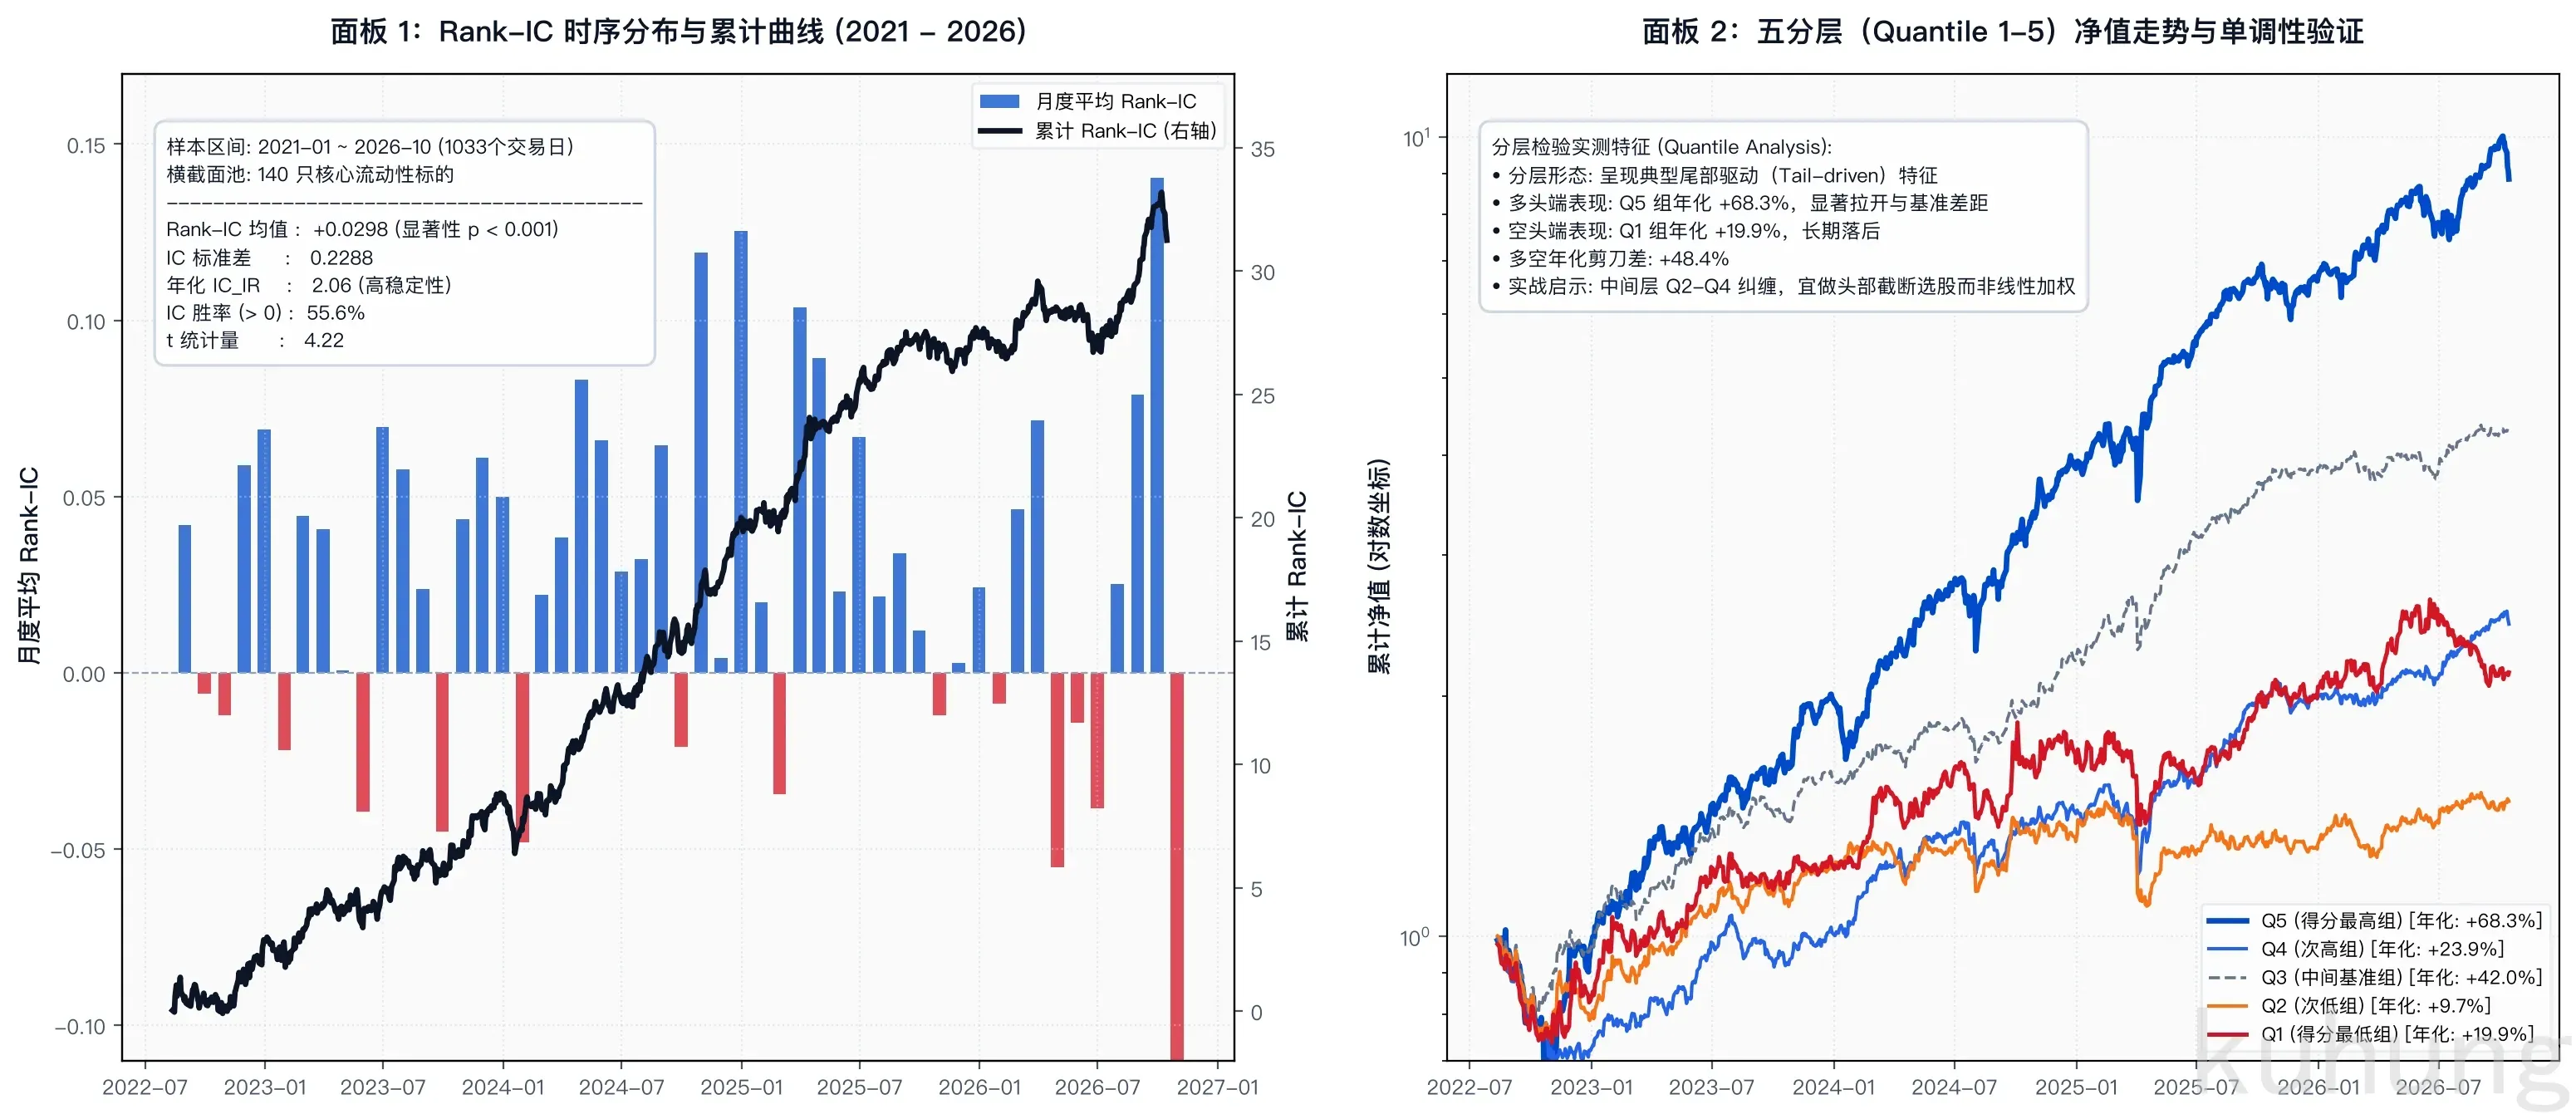
观察上方实测图表的面板 2,可以清晰识别出量化因子分层的两大核心特征:
1. 单调性阶梯与多空剪刀差
理想的 Alpha 因子在各组净值上应当呈现自底向上的严格阶梯递增:。
实测数据显示:
- 多头最高组(Q5):年化复合收益率达到 +68.3%,累计净值大幅拉开与中性基准的差距;
- 空头最低组(Q1):年化复合收益率仅为 +19.9%;
- 多空年化剪刀差:达到 +48.4%。
2. 实战中的“尾部驱动(Tail-driven)”特征
很多初学量化的开发者对教科书有一种执念,认为合格因子必须 5 组收益均匀拉开。
但看图中 Q2(年化 +9.7%)、Q3(年化 +42.0%)、Q4(年化 +23.9%)的走势就会发现,中间三组不仅没有形成完美的均匀级差,反而纠缠在一起。
这正是价量反转因子的典型现实特征:尾部驱动(Tail-driven Alpha)。 极端超跌的前 20% 股票(Q5)在后续数日内具有强烈的流动性反弹与估值修复动力,而中间 60% 波动温和的标的并没有显著的非平稳定价偏差。
工程启示: 当检验发现一个因子呈现“尾部驱动”特征时,在组合构建阶段决不能使用全截面线性加权(那会把中间大量无预测力的噪声标的强行纳入持仓),而必须采用头部截断法(Top Quantile Screening),只对排名前 10% 或 20% 的优势组赋予权重。
关卡三:时序衰减与因子半衰期(Half-life)
一个因子今天有效,并不代表它能让你躺平持有三个月。
确定因子的时序衰减曲线,核心任务是回答一个工程落地问题:策略到底该隔几天调一次仓?
通过计算当前因子与未来滞后第 天收益率的截面 Rank-IC:
可以绘制出一条清晰的因子预测力衰减曲线。
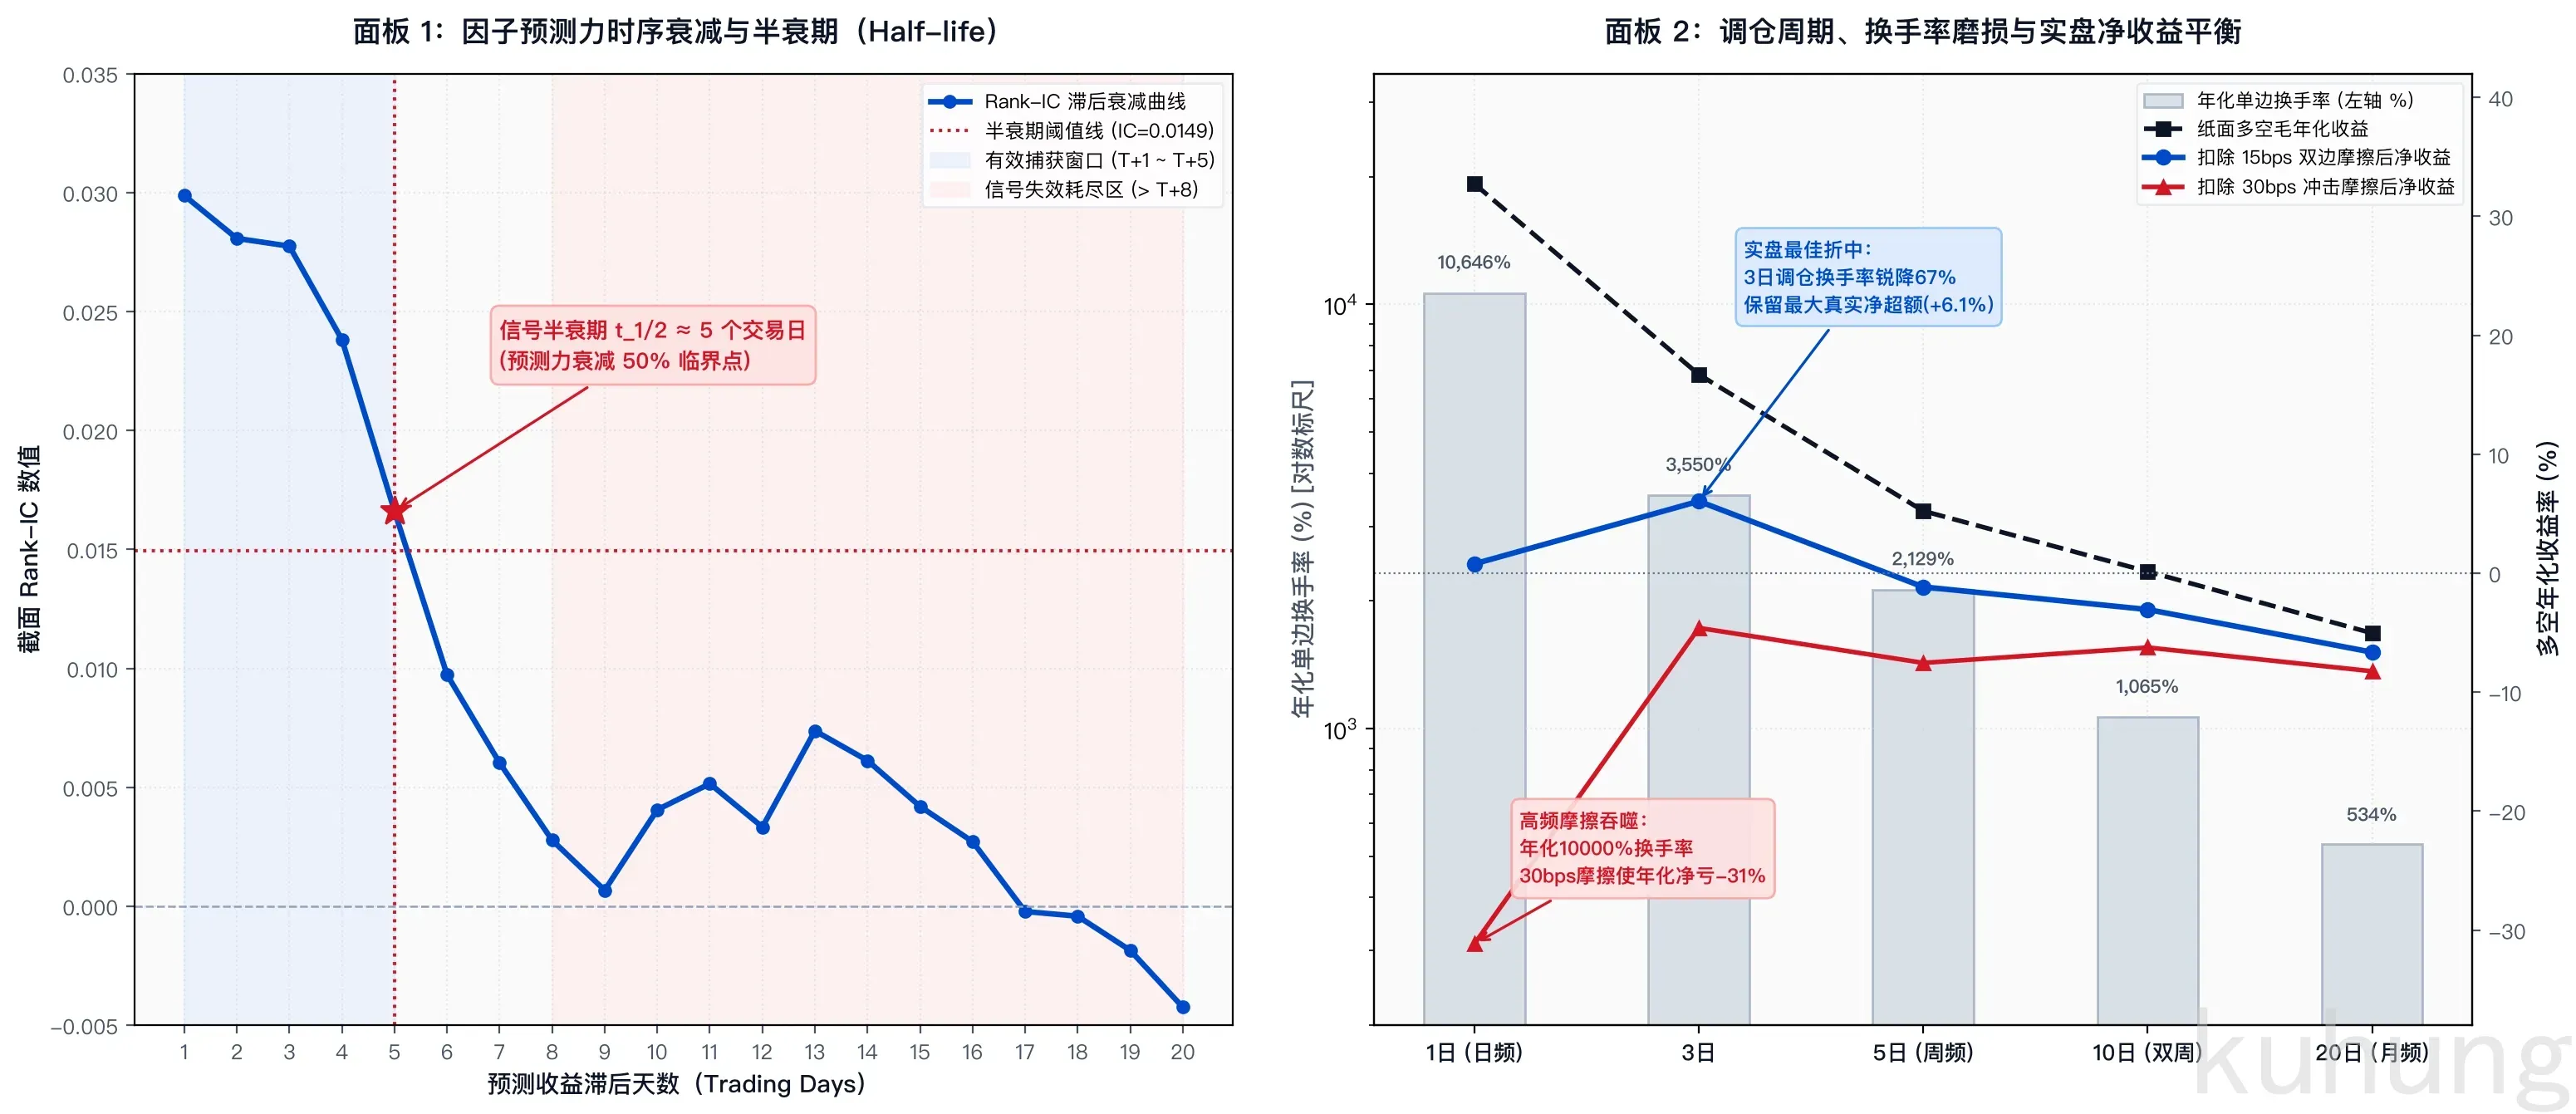
因子半衰期()与持仓窗口
如上方图表的面板 1 所示:
- 天:Rank-IC 达到峰值
+0.0299; - 至 天:Rank-IC 保持在
+0.028左右的平台期; - 天:Rank-IC 下降至
+0.0166,预测力相比初始值恰好折损约 50%。这代表该因子的生命半衰期 个交易日; - 天之后:Rank-IC 跌落至零轴附近甚至转负,原有的预测信息完全被市场噪音与随机游走所稀释。
结论: 该因子的有效捕获窗口在 到 之间。如果回测框架将调仓周期设为月度(20 个交易日),那么在后半程的 15 天里,组合本质上是在裸奔持有已经失效的随机噪声。
关卡四:换手率与交易摩擦的物理侵蚀
很多量化研究员在模拟环境跑出了惊艳的夏普比率,一旦挂上实盘跑一个月就亏损累累。最根本的原因,就是没有把换手率和执行摩擦放在单因子检验的首位。
对于持有前 只标的的等权多头组合,单次调仓的单边换手率定义为持仓权重的变化量之半:
年化单边换手率即为单次换手率乘以年调仓次数。
交易摩擦的双倍惩罚
如果在回测中假设每次调仓的单边交易摩擦为 (包括券商佣金、规费、印花税及市场微观冲击成本),买入与卖出各发生一次摩擦,那么年化摩擦对收益的吞噬为:
看上方图表第二张图的面板 2,对比不同调仓周期下的换手率与净收益表现:
| 调仓周期 | 年化单边换手率 | 纸面多空毛年化收益 | 扣除 15bps 摩擦后净收益 | 扣除 30bps 冲击后净收益 | 最终实盘判定 |
|---|---|---|---|---|---|
| 1日 (日频) | 10,646% (106倍) | +32.7% | +0.8% | -31.1% | 彻底被摩擦吞噬,实盘巨亏 |
| 3日 | 3,550% (35倍) | +16.7% | +6.1% | -4.6% | 最佳平衡折中点 |
| 5日 (周频) | 2,129% (21倍) | +5.2% | -1.2% | -7.5% | 信号衰减过半,毛利不足 |
| 10日 (双周) | 1,065% (10倍) | +0.1% | -3.1% | -6.2% | Alpha 耗尽 |
| 20日 (月频) | 534% (5倍) | -5.0% | -6.6% | -8.2% | 逆向漂移 |
物理世界的残酷证据
实测数据揭示了一个冰冷的现实:
- 高频纸面幻觉:如果采用日频调仓,纸面多空毛年化收益高达 +32.7%。但年化单边换手率高达惊人的 10,646%(资金一年在市场里翻滚了 106 次)。
- 摩擦吞噬:即便只按双边 15bps(单边万分之七点五)这种只有顶级机构能拿到的执行费率计算,年化摩擦损耗就高达 ,将毛收益抹杀到只剩 +0.8%;而一旦叠加真实市场的流动性冲击成本(假设双边 30bps),净收益直接暴跌为 -31.1%!
- 真实最优解:将调仓步长放宽至 3 天,年化换手率骤降 67% 至 3,550%,在保留了大部分半衰期内有效 Alpha 的同时,成功抵御了摩擦,留存了最高 +6.1% 的年化净超额。
工业级单因子向量化评估实现
为了避免在 Python 中使用低效的多重 for 循环,以下提供可以直接在日 K 线矩阵上运行的单因子向量化评估引擎代码。
该代码内建了对除权跳空脏数据的过滤保护、Rank-IC 时序序列计算、五分层收益统计以及换手率测算:
import numpy as np
import pandas as pd
from scipy.stats import spearmanr

def evaluate_factor_pipeline(
    close_df: pd.DataFrame,
    factor_df: pd.DataFrame,
    quantiles: int = 5,
    max_clean_ret: float = 0.35,
    rebalance_step: int = 3,
    friction_bps: float = 15.0
):
    """
    工业级单因子向量化检验管线

    参数:
    - close_df: 收盘价对齐矩阵 (trade_date x symbol)
    - factor_df: 待检验因子矩阵 (trade_date x symbol)
    - quantiles: 分层组数 (默认 5 组)
    - max_clean_ret: 过滤未复权跳空脏数据的日涨跌幅阈值 (默认 35%)
    - rebalance_step: 调仓步长交易日 (默认 3 天)
    - friction_bps: 双边交易摩擦基点 (默认 15 bps = 0.15%)
    """
    # 1. 脏数据清洗:过滤除权或数据单位跳空异常
    ret_1d_raw = close_df.pct_change()
    clean_mask = ret_1d_raw.abs() > max_clean_ret
    close_clean = close_df.mask(clean_mask)
    fwd_ret_1d = close_clean.pct_change().shift(-1)

    # 2. 截面 Rank-IC 与 IC_IR 计算
    # 每日横截面转换为百分位排名
    rank_f = factor_df.rank(axis=1, pct=True)
    rank_r = fwd_ret_1d.rank(axis=1, pct=True)

    daily_ic = rank_f.corrwith(rank_r, axis=1).dropna()

    ic_mean = daily_ic.mean()
    ic_std = daily_ic.std()
    ic_ir = (ic_mean / ic_std) * np.sqrt(250)
    ic_win_rate = (daily_ic > 0).mean()
    t_stat = ic_mean / (ic_std / np.sqrt(len(daily_ic)))

    # 3. 五分层收益计算 (Quantile Analysis)
    quantile_rets = {g: [] for g in range(1, quantiles + 1)}
    q_dates = []

    for d in factor_df.index:
        f_s = factor_df.loc[d].dropna()
        r_s = fwd_ret_1d.loc[d].dropna()
        common = f_s.index.intersection(r_s.index)
        if len(common) < 30:
            continue
        try:
            q_labels = pd.qcut(f_s[common], quantiles, labels=range(1, quantiles + 1))
            for g in range(1, quantiles + 1):
                quantile_rets[g].append(r_s[common][q_labels == g].mean())
            q_dates.append(d)
        except Exception:
            continue

    df_q = pd.DataFrame(quantile_rets, index=q_dates)
    cum_q = (1.0 + df_q).cumprod()

    # 4. 换手率与摩擦后净多空收益测算 (基于交错组合平滑)
    rebal_dates = factor_df.index[::rebalance_step]
    to_list = []
    prev_w = pd.Series(0.0, index=close_clean.columns)
    gross_rets = []

    for idx in range(len(rebal_dates) - 1):
        d_now = rebal_dates[idx]
        d_next = rebal_dates[idx + 1]

        f_now = factor_df.loc[d_now].dropna()
        if len(f_now) < 30:
            continue

        n_top = int(len(f_now) * (1.0 / quantiles))
        top_syms = f_now.nlargest(n_top).index
        bot_syms = f_now.nsmallest(n_top).index

        curr_w = pd.Series(0.0, index=close_clean.columns)
        curr_w[top_syms] = 1.0 / n_top

        # 多头单边换手率
        to = 0.5 * (curr_w - prev_w).abs().sum()
        to_list.append(to)
        prev_w = curr_w

        # 期间多空毛收益
        span_ret = (close_clean.loc[d_next] / close_clean.loc[d_now] - 1.0)
        ls_ret = span_ret[top_syms].mean() - span_ret[bot_syms].mean()
        gross_rets.append(ls_ret)

    avg_to_step = np.mean(to_list)
    ann_turnover = avg_to_step * (250 / rebalance_step)

    total_gross = np.prod([1.0 + r for r in gross_rets])
    n_days = (pd.to_datetime(rebal_dates[-1]) - pd.to_datetime(rebal_dates[0])).days
    ann_gross_ret = (total_gross ** (365 / max(n_days, 1)) - 1.0)

    # 扣除双边摩擦
    ann_friction = ann_turnover * (friction_bps / 10000.0) * 2.0
    ann_net_ret = ann_gross_ret - ann_friction

    return {
        "ic_summary": {
            "mean_rank_ic": ic_mean,
            "annual_ic_ir": ic_ir,
            "win_rate": ic_win_rate,
            "t_statistic": t_stat
        },
        "quantile_cum_returns": cum_q,
        "execution_summary": {
            "annual_turnover": ann_turnover,
            "ann_gross_ret": ann_gross_ret,
            "ann_net_ret": ann_net_ret,
            "friction_drag": ann_friction
        }
    }
因子准入实盘的四项一票否决权
在量化投研流水线中,任何一个新因子在进入组合优化器(Optimizer)之前,都必须通过这四项一票否决指标的审查:
- Rank-IC 显著性一票否决:
- 截面 Rank-IC 均值必须 ,且 t 统计量绝对值 。无法通过统计显著性检验的因子,其历史回测净值再高也是过拟合噪音。
- 分层极端倒挂一票否决:
- 多头最高组(Q5)必须显著跑赢中性基准(Q3);若出现 Q1 收益高于 Q5 的系统性倒挂,或者各组净值完全无序乱麻,说明信号缺乏横截面区分度。
- 半衰期与调仓周期错配一票否决:
- 策略调仓周期必须严格小于或等于因子半衰期 。用月频调仓去跑日内或 2 日价量因子,或者用日频调仓去跑半年更新一次的财报 ROE 因子,均为系统性架构错配。
- 扣除摩擦后净收益为负一票否决:
- 必须基于该因子的实际换手率,按实盘保守执行成本(双边 15-30bps)做摩擦扣减。如果扣除摩擦后的多空净收益 ,无论纸面毛收益多诱人,都必须坚决从候选池剔除。
只有同时跨过统计预测、截面单调、时序衰减与现实摩擦四道物理关卡,一个因子才真正具备了为投资组合贡献稳健超额收益的可能。