在量化策略的研究和回测过程中,如果策略逻辑、数据处理或撮合假设存在偏差,很容易跑出异常优异的历史净值。这类表面的高收益通常来自统计误差或数据泄漏,无法在真实交易中复现。
这里梳理量化回测中最常见的四类技术问题、产生机理以及对应的检查方法。
一、未来数据泄漏(Lookahead Bias)
未来数据泄漏是指策略在第 日生成信号或执行成交时,无意中读取了 日之后(或 日尚未公布)的信息。这类错误在代码实现上往往不报错,但会大幅虚增回测收益。
常见的三种泄漏场景:
1. 信号计算与成交撮合时点重叠
在日频回测中,最常见的错误是在使用当日收盘价计算信号的同时,又假设以当日收盘价(甚至当日开盘价)完成成交。
如果信号依赖第 日的收盘价 ,在真实市场中,该价格只有在收盘集合竞价结束(如 15:00)后才能确定。策略要么只能在第 日开盘或盘中执行买入,要么只能使用截至 日盘中(如 14:50)的截面数据生成预估信号并挂单。如果在回测中直接把第 日收盘价计算出的权重赋予第 日的收益计算,就等于利用了收盘前无法确定的信息。
2. 财务报表披露时滞错位
上市公司财务数据的报告期截止日与实际披露日存在时间差。例如三季报的财报周期截至 9 月 30 日,但交易所允许在 10 月 31 日之前陆续披露。
如果回测系统直接使用季度标签 2025-09-30 作为数据的可获取时间戳,就会导致策略在 10 月初提前使用了 10 月底才公开的财务指标。
3. 复权因子计算中的未来信息
股票历史价格通常需要进行复权处理以消除送转股、分红派息带来的价格跳空。如果使用前复权(Forward Adjustment),每次发生分红送股时,历史所有的价格序列都会向下平移折算。这意味着历史的“前复权价格”会随着未来除权事件的发生而动态改变,直接基于前复权价格计算绝对价格门槛(如突破前期高点)容易引入未知偏差。
向量化防未来数据实现
在代码层面,阻断未来数据泄漏的关键在于强制执行时序滞后(Lag)与真实公告日向后合并(merge_asof):
import pandas as pd

def align_point_in_time_data(
    market_prices: pd.DataFrame,
    financial_announcements: pd.DataFrame
) -> tuple[pd.DataFrame, pd.DataFrame]:
    """
    通过滞后一个交易日与公告日向后合并,防止未来数据泄漏
    """
    # 1. 交易信号使用截至 t-1 日收盘价计算,确保在第 t 日决策时数据已完全固化
    decision_prices = market_prices.shift(1)

    # 2. 财务指标必须按公告发布日(ann_date)而非财报截止日(end_date)对齐
    aligned_features = pd.merge_asof(
        decision_prices.index.to_frame(name="trade_date"),
        financial_announcements.sort_values("ann_date"),
        left_on="trade_date",
        right_on="ann_date",
        direction="backward"
    ).set_index("trade_date")

    return decision_prices, aligned_features
自检排查方式:
- 严格遵循 Point-in-Time(时间切片点真实可得)原则,财务数据以实际公告披露日(Announcement Date)为准入库;
- 信号生成时显式做滞后处理:使用截至 日的数据生成目标持仓,在第 日按执行算法撮合成交;
- 行情使用后复权(Backward Adjustment)或直接使用未复权的原始价配合除权系数计算。
二、幸存者偏差(Survivorship Bias)
幸存者偏差指的是在回测选股时,使用了“当前已知存在”的股票池,反向推导过去的选股结果。
表现机制
如果要在 2018 年至 2025 年之间回测一个沪深 300 成分股轮动策略,直接获取今天(2026年)的沪深 300 成分股列表并作为过去 7 年的股票池,就会产生严重的幸存者偏差。
原因在于:目前能留在沪深 300 里的公司,多数在过去几年中市值和业绩表现相对平稳;而过去 7 年间因业绩大幅下滑、重大违规、甚至退市而被剔除出指数的公司,根本不会出现在今天的成分股名单中。用今天的名单倒推历史,相当于人为剔除了所有历史上表现最差的标的。
影响幅度
根据相关实证研究,在股票多头策略回测中,如果不剔除退市股和历史成分股调整,幸存者偏差每年可能虚增 1% 到 5% 不等的年化超额收益。
自检排查方式:
- 必须使用逐日变动的动态成分股数据(Historical Universe),每期股票池只包含当时时点上指数实际纳入的成分股;
- 股票全市场扫描时,必须包含已经退市、暂停上市或被实施风险警示(ST)的历史完整样本。
三、参数过拟合与数据窥探(Overfitting & Data Snooping)
参数过拟合是指策略规则过多、参数窗口过于定制,以至于模型拟合了历史样本中的随机扰动噪声,而不是真实的统计规律。
常见形式
- 多重假设检验无惩罚:测试了 10 日、11 日、12 日……直至 120 日均线,最后选出夏普比率最高的一个(如刚好 37 日均线),并声称发现了该资产的运行周期;
- 条件叠加过度:为了规避历史回撤,在主策略上不断增加过滤规则(如“指标A大于0,且指标B小于20,且周三不买入”),每多加一个条件,历史曲线看起来更好,但策略自由度迅速枯竭。
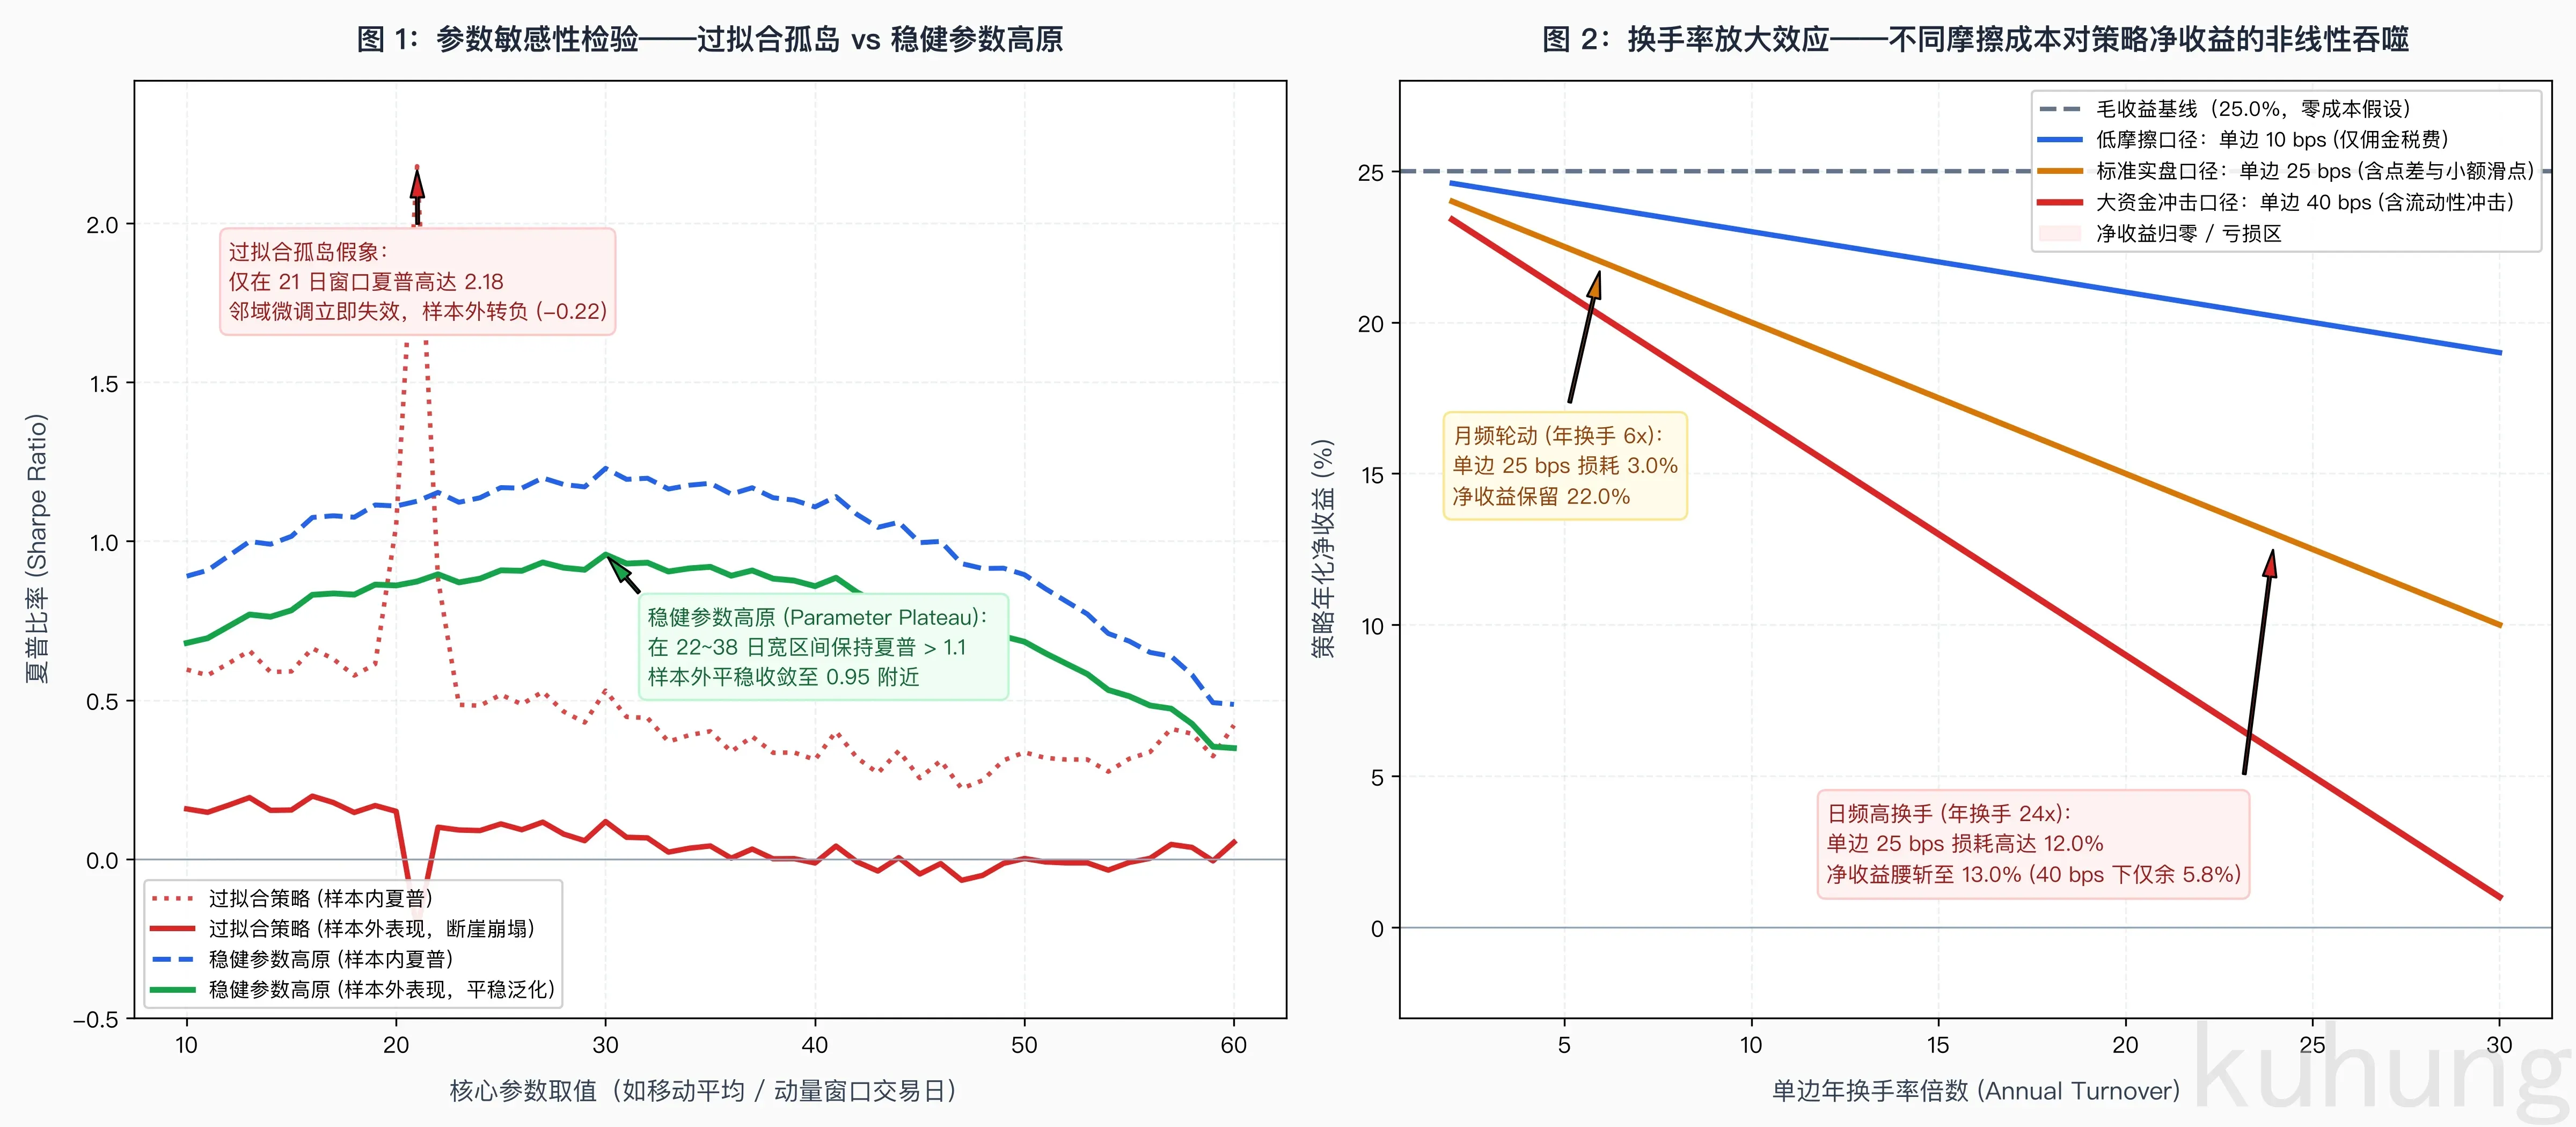
识别方法:参数敏感性检验
检验参数是否过拟合,可以直接观察参数敏感性曲线与样本外衰减(如上图 1 所示):
- 过拟合孤岛(Island Spike):策略仅在极窄的窗口(如 21 日)上表现异常突出(样本内夏普高达 2.18),但只要窗口微调至 20 日或 22 日,指标立即断崖式下滑。当把该策略放到未参与调参的样本外区间检验时,夏普比率直接击穿至 -0.22。这说明 21 日窗口只是凑巧拟合了特定区间的短期极端波动;
- 参数高原(Parameter Plateau):可靠的规律在参数微调时应当具备连续性。如图 1 绿线所示,稳健策略在 22 至 38 日的连续宽区间内,样本内夏普稳定维持在 1.1 以上,在样本外依然平稳收敛至 0.95 附近,没有出现断崖崩塌。
自检排查方式:
- 划分互不重叠的训练集(In-Sample)与测试集(Out-of-Sample),在测试集上冻结参数只跑一次;
- 检查参数高原(Parameter Plateau):可靠的策略应在参数网格的连续邻域内保持稳定表现。
四、交易摩擦与成本漏算(Execution Friction)
在纸面回测中,交易往往被假定为在无摩擦环境中瞬间完成,但真实执行存在明确的物理损耗。
真实交易摩擦通常由三部分构成:
1. 手续费与税费(Commission & Tax)
包括经纪商佣金、经手费、证管费以及卖出时的印花税。虽然目前单笔费率较低,但高换手策略(如日频全仓换手)每年累积的硬性税费依然非常可观。
2. 买卖盘口点差(Bid-Ask Spread)
主动买入时必须吃掉盘口的卖一价,主动卖出时必须打到买一价。对于流动性充裕的标的,点差可能只有万分之几;但对于流动性较弱的中小市值标的,点差常年维持在千分之一至千分之三以上。每次进出都会承受半个点差的固定损失。
3. 市场冲击成本(Market Impact)
当订单金额占到标的单日成交额(ADV)的较高比例时,主动性大额订单会推高股价(买入时)或压低股价(卖出时)。根据微观市场结构的经验法则,市场冲击通常与订单占比的平方根成正比:
其中 为交易规模, 为标的日均成交量, 为波动率。回测如果假设可以按最新收盘价无限制无限量成交,大资金量下就会完全失真。
4. 换手率对净收益的非线性侵蚀
如图 2 所示,在 25% 的毛收益基线假设下,调仓频率和换手率直接主导了最终能落袋的净收益:
- 月频低换手(年换手 6x):单边 25 bps 摩擦(含点差与小额滑点)全年累计损耗约 3.0%,策略依然能够保留 22.0% 的年化净收益;
- 日频高换手(年换手 24x):同样的单边 25 bps 摩擦损耗会迅速放大至 12.0%,年化净收益直接腰斩至 13.0%;若资金体量扩大导致单边冲击升至 40 bps,净收益仅余 5.8%,大部分超额均在撮合过程中被物理损耗殆尽。
自检排查方式:
- 在回测中引入分档成本压力测试(如 0 bps、10 bps、30 bps),观察策略对摩擦成本的敏感度;
- 统计策略换手率与持仓周期,明确策略可承载的资金容量上限;
- 加入整手(100股)交易约束和涨跌停板不可成交限制。
总结
量化回测是一个通过严谨假设检验策略有效性的过程。如果在数据时点上避免偷看未来、在股票池中保留真实历史动态、在参数检验中防范过拟合,并如实计入市场物理摩擦,得出的回测指标才能为后续的实证研究提供可靠的参考依据。